
先日、経営者交流会の主催やエンジニア企業代表の方と話していて、「外国語話者との打ち合わせで同時通訳があると助かる」なんて話になり、音声認識にも興味がありつつ、これまでプロジェクトもなく機会が無かったので、ブラウザだけで動く同時通訳ツールを作ってみた。
要素は3つしかない。音声認識(STT)、自動翻訳(MT)、音声合成(TTS)。どれも枯れた技術で、つなぐだけなら半日で動きそう。
 ブラウザ・Workers・外部APIの役割分担
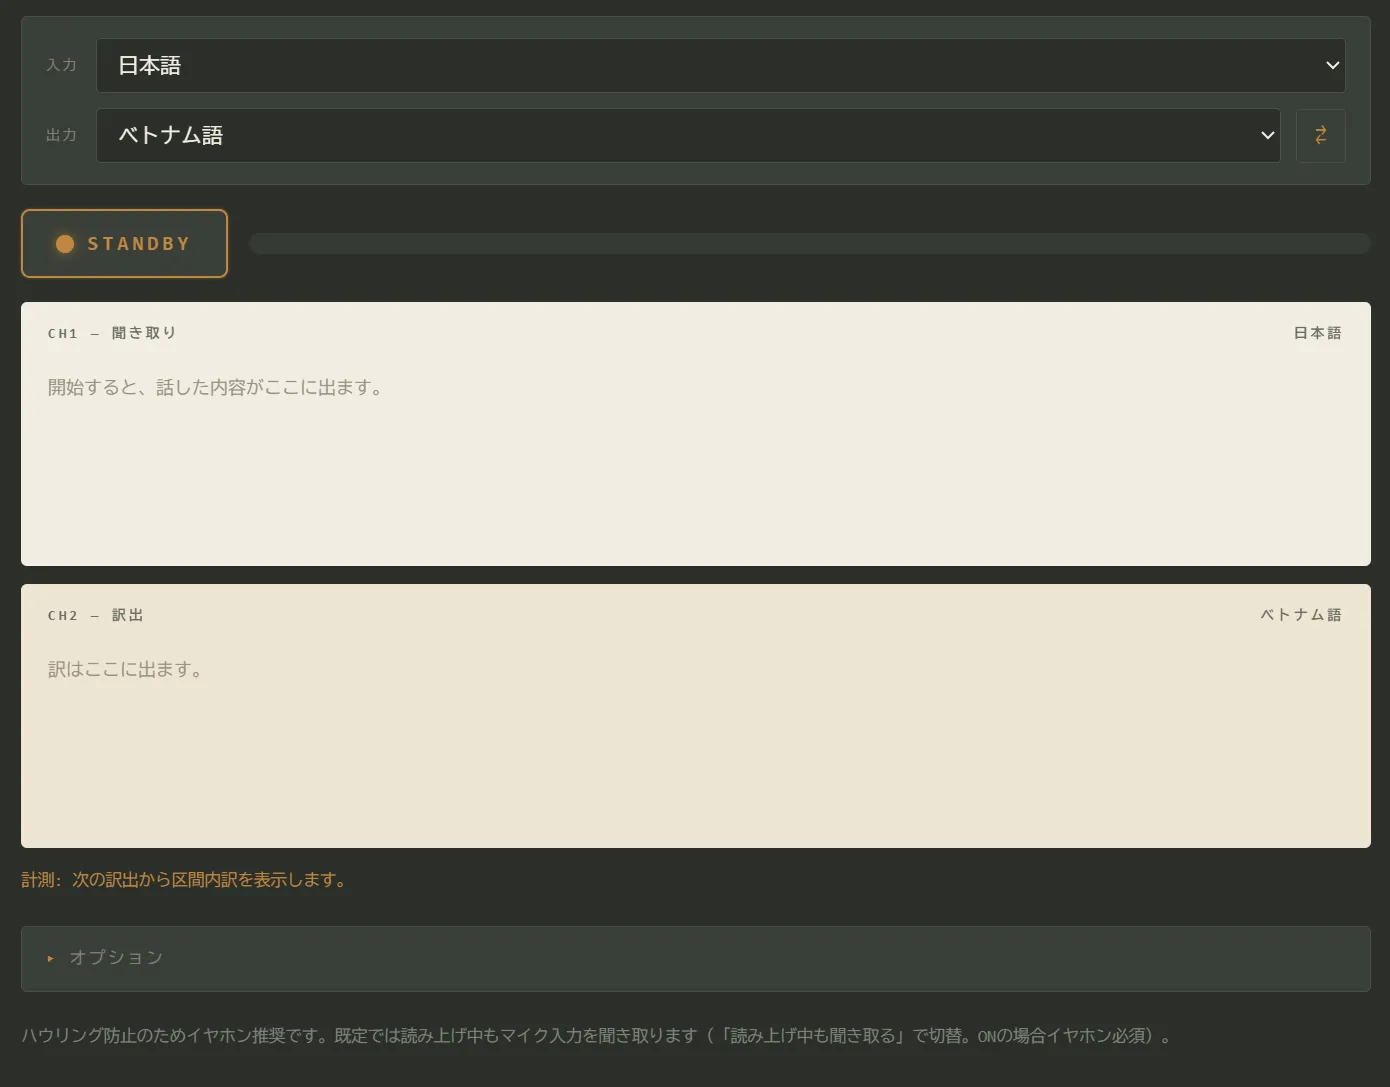 画面構成
音声認識はWeb Speech APIを使う。標準仕様ではないみたいだけどChrome系やSafariは対応している。自動翻訳と音声合成は外部APIを使うので、Workersが中継するようにする。ブラウザ(フロント)側から呼ばれるWorkersのAPIはこんなインターフェースにした。
- 入力はJSON形式
項目 型 必須 説明 qstring 必須 訳したいテキスト sourcestring 必須 元の言語 targetstring 必須 訳す先の言語 languageCodestring 必須 読み上げる言語 namestring 任意 音声の種類 ratenumber 任意 読み上げ速度。既定は 1.0
- 出力はストリーミングで返す。1行に1つのJSONを返し届いた行から処理される想定
type一緒に返る項目 説明 texttext訳文。最初に1行だけ返る audiotext,audioContent文ごとの音声。訳文のあとに順次。 audioContentはbase64のMP3errortext,errorその文の音声合成に失敗したとき
同時通訳っぽくするには
最初は素直に作ってみた。音声認識が確定したら翻訳して返ってきた訳文を読み上げる感じで、まぁ、これでも良いかもしれない。また、文章が長い場合に文字数で自動で区切るようにしているので、自動で翻訳が始まってしまい、変なところで文がきれてしまう。Web Speech APIは認識中も仮の結果を返してくれるらしく、これは後から書き換わる。ただ、書き換わるのはたいてい末尾で、前のほうは早い段階で固まっているらしい。そこで直近2つの仮説を見比べて、先頭から何文字目まで同じかを数える。そこまでは書き換えが起きなかった部分なので、もう動かないとみなして翻訳を始められるようにしてみた。local agreementと呼ばれる考え方らしい。
1つ前: 資料を確認しま
最新 : 資料を確認しましたので
        ~~~~~~~ ここまで一致。もう動かないとみなす
言い直しが入ると一致が短くなるので、直された部分は自動的に対象から外れてくれる。この一致した範囲の中から区切りを探して、そこまでを先に訳して読み上げる。確定したときは、読み上げ済みの部分を差し引いた残りだけを訳す。前に出した訳と後から出る訳で表現が揺れることはあるが、そこは割り切り、発話の速さを優先してみた。
日本語をどこで切るか
一致した範囲が取れても、どこで切るかは別の問題になる。文字数で機械的に切ると節の途中で分断され、訳が崩れる。最初は18文字で切っていたが、細切れになりすぎて文脈が失われることがあった。形態素解析を入れる手もあったが、ブラウザで動かすには重いと判断し、結局、述語の末尾に出るパターン(〜ので、〜ますが、〜です、など)を正規表現で拾う軽い方法にしている。
資料を確認しましたので次の議題に移ります
  ↓
「資料を確認しました」 + 「ので次の議題に移ります。」
ただ、以下のように、終助詞が切り離されてしまって、「ね」だけ変な翻訳になってしまうことがあったので、終助詞が付くパターンも語尾パターンに含めることにした。
地震は怖かったですね
  ↓
「地震は怖かったです」 + 「ね」
まぁ誤爆はするが、外しても数文字ずれる程度で、訳が壊れるところまではいかない、完璧を狙わない、という設計にした。
往復を減らして最初の音を早く出す
区切って先に訳せるようになると、今度は通信速度が気になってくる。
翻訳と読み上げを別々のエンドポイントにしていたので、区切りごとにブラウザとWorkersを2往復していた。これを1つにまとめて、結果をNDJSON(1行に1つのJSONを並べる形式)で少しずつ返すようにした。普通のJSONは全体が閉じるまで読めないが、これなら行ごとに完結しているので、届いた順に処理できる。1行目に訳文のテキスト、そのあとに文ごとの音声が続く。こうすると字幕が先に出る。音声は先頭の文から順に鳴り始めるので、全部の音声が揃うのを待たなくていい。語順が大きく変わる言語どうしでも、遅れを字幕が吸収してくれる。
それでも読み上げが溜まることはある。ここで古いものを捨てると話の一部が消えてしまうので、捨てずに再生速度を上げて追いつく方式にした。溜まっている量に応じて速くなり、上限は1.5倍。ピッチは保つので、早口になるが聞き取れる。
まとめ
やっていることを分解すると音声認識も自動翻訳も音声合成も、既製のAPIを呼んでいるだけになる。個々はどれも枯れていて、自分で作った部分はほとんどない。ただ、そのまま作ると単調なものになってしまうけど、ちょっと工夫するだけでも体感はまるで違うものになった。差が出たのは全部つなぎ方のほうで、いつ区切るか、何を先に出すか、遅れたときにどう追いつくか、みたいなことを考えて改善するの、とっても面白いよね~。
ただ、同時翻訳してみて思ったんだけど、同時に翻訳されるとしゃべりにくくない?!なんて本末転倒なことを思ってみました~
LOOPSKETCHでは、こうしたツールの構築もご相談いただけます。よろしければ、メニューのお問い合わせからどうぞ。この翻訳ツールを使ってみたいという方もご連絡ください!